开源一款网页高亮、批注与 AI 理解的 Chrome 插件
平时上班摸鱼我都会在浏览器里读一些感兴趣的文章,看到讲得有意思的段落就划一道,有不同想法的时候还想添上一两句批注,比如记下自己踩过的坑,或者对这处结论存疑。最麻烦的是遇到一些不同学科的专业术语。一个没见过的词卡在句子中间,我得开个新标签页去搜,或者打开 ChatGPT 去询问,搜完还要再回来当前的页面。这样操作很繁琐,因为我只是想简单的知道这个术语的含义而已。
所以今年 5 月,我把这两件事做成了一个 Chrome 插件。划线、批注和术语解释都收在同一个地方,要进笔记库的时候,整份导出成 Obsidian 的 Markdown 就行。同时,也让它支持了跨设备同步的功能,换电脑的时候,登录同一个账号,这些内容也能跟过来。
这款 Chrome 插件叫六彩,目前是 1.0.0,基于 MIT 协议,仓库在 https://github.com/phoenine/liucai。
1. 划一条线之后,页面上多出来的东西
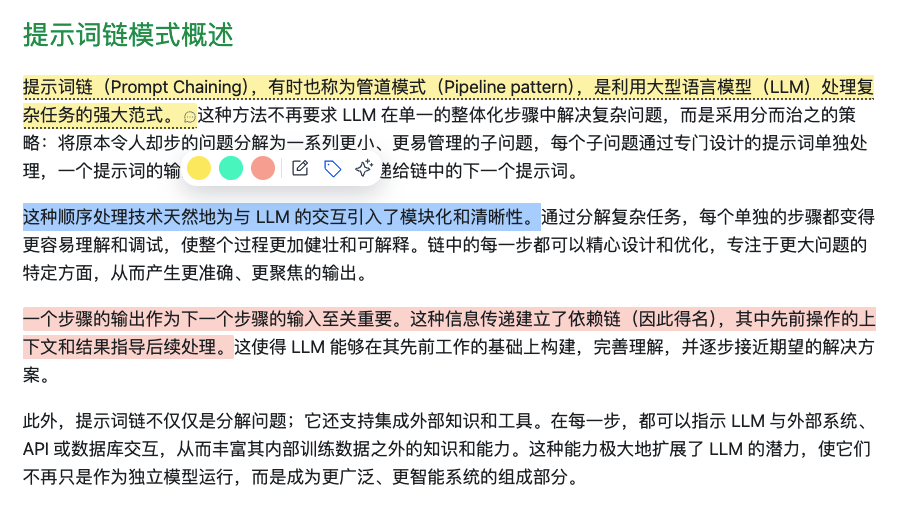
在 Chrome 里加载好这个插件以后,随便打开一篇普通网页就能用。选中一段文字,工具条会出现在选区边上,目前支持暖黄、薄荷、珊瑚三种颜色,点一下高亮就建好了。旁边还有批注和标签两个入口,先写批注再划也行。
不过这个工具条给什么按钮,要看你眼下在做什么。
- 第一次划选,这段文字还没有高亮。给的是三个颜色圆点,右边跟着批注和标签,登录之后再多一个 AI按钮。
- 在一条高亮里面再划一小段。这时候只剩一个 AI按钮,没登录就不出现。
- 什么都不选,只点一下已有的高亮。给的是调色盘、批注、标签、复制摘录、删除,颜色收进调色盘里,点开才展开。
这里的判断顺序是先看有没有选中文字,再看这段文字在不在已有高亮里。有选区、不在高亮里,就建一条新的;有选区、在高亮里,就是问这一小段在说什么;没有选区的单击只管这一条现有的。其中第二种是我特意分出来的。我在高亮内部再划一段,多数时候关心的是这一小段本身,不需要再来一遍颜色和标签。
高亮建好之后,批注和标签是另外两个入口。批注能写普通段落,也能写有序或无序列表,敲下 1. 或者 - 之后回车会自动接上下一行。标签用中英文逗号、换行分隔都行,重复的会去掉。带批注或标签的高亮有个小标记,鼠标停上去能看见内容,这层提示挂在页面顶层,不会被正文的样式和层级吃掉。
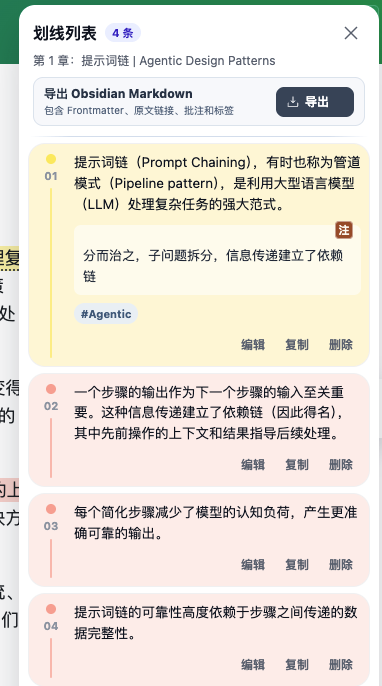
划过的线都在页面右侧那个侧栏里。点一条可以跳回原文位置,同时可以方便的进行编辑、复制、删除操作。复制出来就是 Obsidian 的 callout 格式,原文链接、摘录、批注、标签都在;点导出会下载一份带 frontmatter 的 Markdown,上面记着创建时间、划线数量和原文链接。目前还没有开发Obsidian的同步功能,所以暂时做了当前的Workaround,后面的版本会持续更新同步Obsidian功能。
关掉页面再打开,高亮自己会回来。这一步处理的是定位,保存摘录时把文本位置和前后文一起记下来,页面结构有小改动也能对上。另一个麻烦在网址上,同一篇文章带不带 utm 参数其实是同一页,页面身份按规范化之后的地址算,不然侧栏里会冒出两条。
2. 不认识的词,就地弄明白
划线管的是我自己的话,遇到不懂的词,六彩还管另一件事。
“记忆交错”这个词,我是在一篇讲 MSA 长时记忆架构的文章里碰到的。文章说这个机制管多跳推理,我读完只记住有这么个东西,具体怎么交错完全没概念。后来拿这个词试 AI 解释,第一版念下来还是一串术语,绕一圈回来,我还是没弄清它到底怎么工作。点开下面的「举个栗子🌰」,第二版才把话说到我能接住的地方。
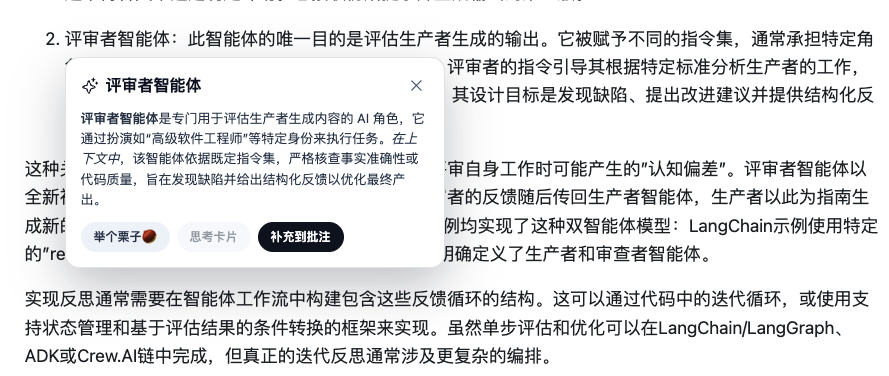
这个 AI 要登录之后才会出现在工具条上。选中一个词点一下,解释一段段流出来。上面那个栗子按钮就在解释卡里,第一版没讲明白的时候用得着。解释和例子都能「补充到批注」,跟这条高亮一起存着,导出的时候一起进笔记。
解释只带选区附近的上下文,最多两千字。整页正文发过去,模型容易扯到别的地方;只发选中那几个字,又不够它判断这个词在这句话里是什么意思。
还有一点,AI 的请求只在点了之后才发。划选、悬停、打开页面都不会把正文送出去,请求里只有选中的文字和附近的上下文。页面标题和 URL 不带,上下文已经够回答这个词的意思,标题和链接没必要跟着出门。
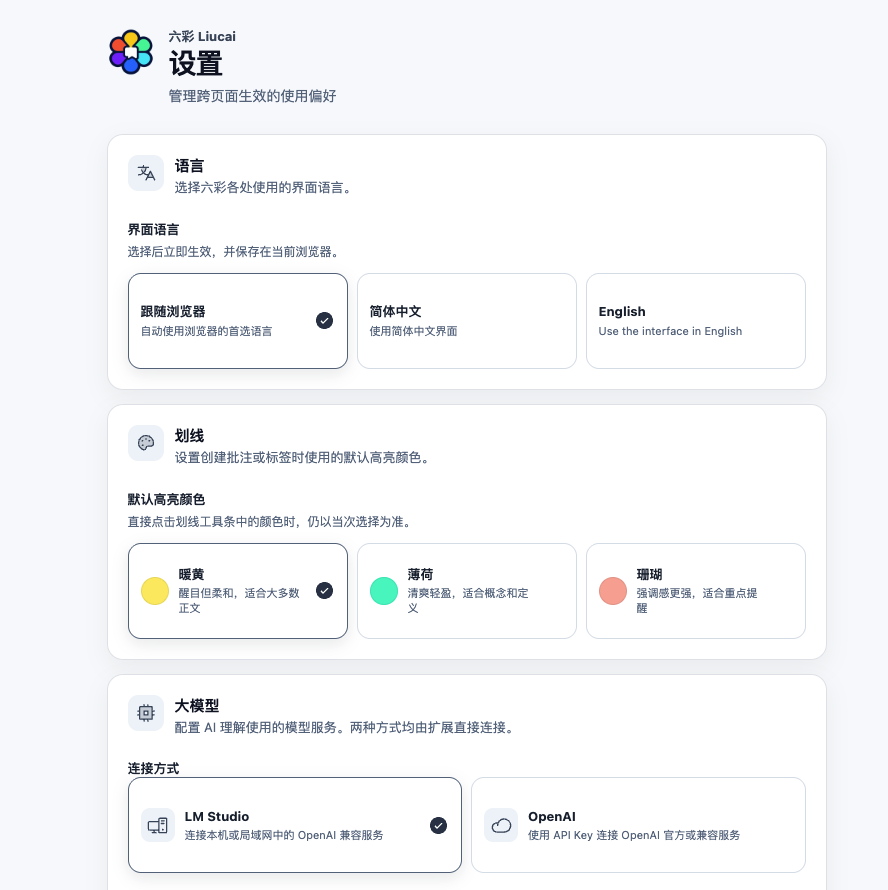
轻解释和例子跑在无推理模式下,图的是快。模型服务能接两种,一种是本机或局域网里的 LM Studio,地址默认 http://localhost:1234/v1,另一种是 OpenAI 官方或任何兼容的 HTTPS 服务。地址、模型 ID 和凭据都在设置页填,填完先点一次测试连接,不通会当场告诉你。同一页还有界面语言(跟随浏览器、简体中文、English)和创建批注或标签时的默认颜色。
3. 不登录也能用,登录多两件事
上面说的都是页面上看得见的部分,数据存在哪里是另一回事。

不登录的时候,高亮、批注、标签先写进扩展自己的 IndexedDB,写完就算落地,不等网络。没有账号、断网、服务端暂时不可用,本地这些照常跑。
这里有个细节,本地这次写入和那条待上传记录放在同一个事务里提交。本地存好了但记账失败,这次修改以后就再也传不上去,两件事只能一起成功。
登录之后,同步会自己找时机跑起来,登录时、后台启动时、打开普通网页时,还有每次新增或删除划线之后,另外每 5 分钟查一次。Popup 里能手动点立即同步,状态也在同一处看。
新电脑登录同一个账号,云端数据会下载回本地。有一个前提,还没上传成功的本地记录如果被删掉,云上找不回来。
访客和每个账号的数据本来就是分开存的。没登录的时候用访客那个库,登录哪个账号就切到那个账号自己的 IndexedDB,高亮、批注、待上传队列和同步游标各归各的。退出或者换账号只是换一个数据库,不会把上一个人的内容顺手上传过去。界面偏好、站点开关和模型连接配置还是整个浏览器共用的。
服务端这边的规矩不多。写入只走一个 RPC,用户身份由服务端自己从会话里取,请求里带的用户标识一律忽略。表级权限用 RLS 隔开,客户端拿着凭据也只能读自己的行。扩展里只放 publishable key,secret 和 service_role 不进去。删除一条划线会在服务端留一条最小记录,离线的设备重新上线,也没法把删掉的内容复活。
4. 自己撸免费的 Supabase
看到这里如果想自己用一遍,装法和配置是这样。
安装最省事的方式是下现成的包。从 Releases 下载 liucai-extension-v1.0.0.zip,解压到任意目录,打开 chrome://extensions/,开启右上角的开发者模式,点「加载已解压的扩展程序」,选解压出来的目录。升级时重新解压,回到扩展管理页点刷新即可,已保存的数据不会因为普通升级丢掉。
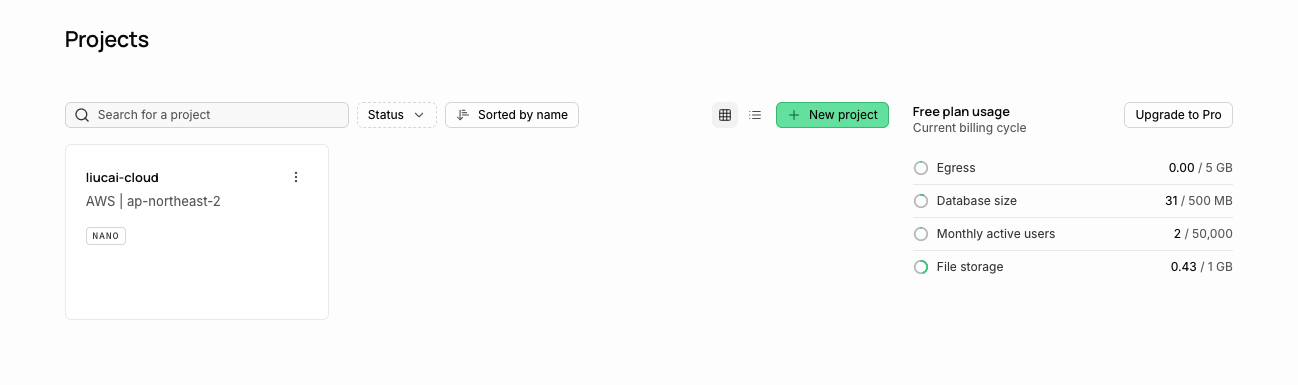
如果希望支持远端同步的小伙伴,Supabase 官网提供了免费的Project,File storage是1GB,但是已经够用了。
接下来简单介绍下云同步的配置步骤:
- 在 supabase.com 建一个项目,记下 Project URL 和 publishable key。想自托管也可以,客户端只用到 Auth 和 PostgREST 两面接口,不需要 Storage 和 Realtime。
- 把数据库结构推上去。仓库里的
supabase/migrations就是完整的数据库契约,一个 SQL 文件。用 Supabase CLI 的话依次执行npx supabase login、npx supabase link --project-ref <你的项目 ref>、npx supabase db push;不想装 CLI,就在 Dashboard 的 SQL Editor 里把这份 SQL 整段执行。 - 从源码构建,把配置写进
.env.local。npm install之后cp .env.example .env.local,填VITE_SUPABASE_URL和VITE_SUPABASE_PUBLISHABLE_KEY两个值,再npm run build,在 Chrome 里加载生成的dist/。这两项留空也能构建,只是没有云同步。 - 打开扩展的 Popup 注册登录。第一台电脑上已有的记录会补建一次待上传快照,之后按批次先传页面、再传高亮。第二台电脑登录同一个账号,数据就跟着过来了。
如果只是想先试试,跳过第 2 到第 4 步,本地划线和导出 Obsidian 一样能用。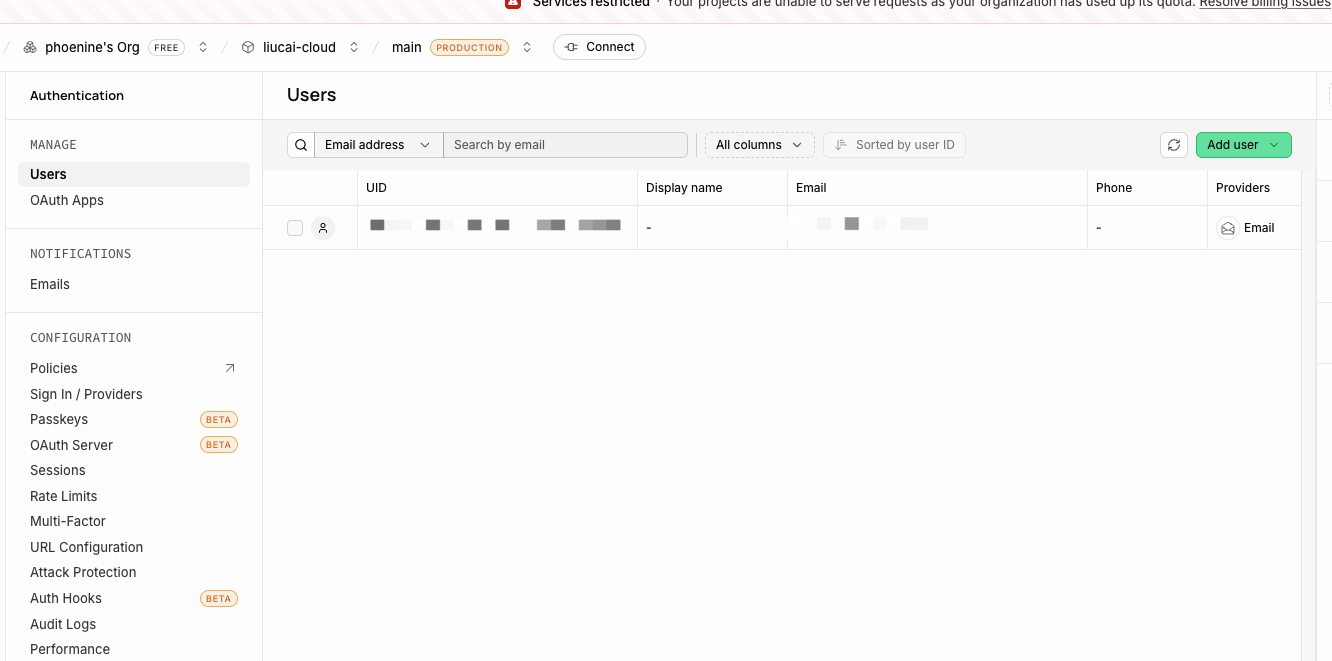
5. 接下来要做的
按我给自己排的顺序,高亮、摘录和 AI 算跑通了,缺的是最后一块,回顾复习。需求已经写完,方向大致是两个东西。
其中一个是思考卡片。对某个概念做一次更完整的加工,内容分成知识点、详细解释和类比,图解按需生成,放在现有的右侧栏里当详情页,不再开第二个面板。卡片和可见高亮是松耦合的,删掉高亮不会把卡片一起删掉。
另一个是回忆遮罩。任意正文选区都能创建遮罩,创建时它只被记下来,页面上的回忆模式要你手动打开。开启之后鼠标进到遮罩范围,光标变成法杖,按住擦拭五次才揭晓答案,前四次只削弱雾层,一次偶然划过不会让答案露出来。键盘用户按 Enter 或 Space 也能揭晓,系统开了减少动态效果就换成短暂淡出。
六彩现在主要是我自己在用,写的时候没打算做成通用产品,功能边界都按我自己的习惯收得比较窄。它开源在 github.com/phoenine/liucai,MIT 协议,安装和配置都写在 README 里。
如果你也在浏览器里读技术文章,试用之后有两类反馈我特别想听。一类是哪些页面上划线跑偏了,另一类是哪些术语解释得不对或者太绕。这两种问题都是我最容易漏掉的。
最后,有希望体验云端但是不想自己搭建云端服务器的小伙伴,可以在后台给我留言发送自己的邮箱账户,我可以暂时将你的账户加到服务器中,名额前 20 名,先到先得。